基于非线性模型预测控制的无人机编队飞行
Zhou Chao, Shao-Lei Zhou, Lei Ming, and Wen-Guang Zhang
Department of Control Engineering, Naval Aeronautical and Astronautical University, YanTai 264001, China
Correspondence should be addressed to Zhou Chao, rickzhou2010@126.com
摘要
我们在非线性模型预测控制(NMPC)框架下设计了一种分布式、无碰撞的编队飞行控制律。编队构型在虚拟参考点坐标系中确定。通过代价惩罚实现避障,通过代价惩罚结合新的优先级策略实现机间防碰撞。
1. 引言
近年来,关于多智能体系统协同控制的研究已得到广泛开展。推动这一研究热潮的动力之一,是分布式多无人机(UAV)在分布式感知和协同作业中的应用 [1]。在多无人机协同控制问题的若干主要子问题中,编队飞行具有重要意义,并得到了广泛研究 $[2,3]$。多无人机编队飞行的主要目标,是在控制整体群体行为的同时,实现期望的群体编队形状 [2]。
针对无人机编队飞行,已提出多种控制方案,如PID方法 [3]、势场法 $[4,5]$、约束力法 [2]、自适应输出反馈法 [6]、滑模控制法 [7] 和基于一致性的方法 [8]。但这些方法无法显式地考虑约束条件,如固定翼无人机的失速速度、角转速约束以及控制输入饱和约束。基于优化的方法能够恰当地处理这些约束,已被证明是解决编队控制问题较为成功的方法之一。其中最为流行的优化方法之一是模型预测控制(MPC)方法。
模型预测控制(Model Predictive Control, MPC),或称滚动时域控制(Receding Horizon Control, RHC),是一种反馈控制方案,在每一个时间步都要求解一次轨迹优化问题。将最优序列中的第一个控制输入应用于系统,并在随后的每一步重复进行优化 [9]。目前该领域研究非常活跃,Mayne 等人在 [10] 对该方法做了详尽综述。它已被广泛用于动态较慢的系统,如化工过程。随着现代计算机运算速度的提升,其应用领域已扩展到多智能体控制和大规模分布式控制问题。其广泛应用的一个动因,是MPC能够处理其他方法难以解决的控制和状态硬约束。集中式MPC已被应用于多车协同控制 [11],但单次优化所需的计算量会迅速变得难以承受,且随着无人车数量的增加,计算复杂度呈极差的扩展性。为了解决这一问题,分布式模型预测控制(DMPC)方法 [12] 通过将优化划分为更小的子问题被提出。
编队控制策略对于编队控制问题而言至关重要。文献中,针对编队控制问题主要有三种信息结构方法:即领航-跟随(leader-follower)[13]、虚拟结构(virtual structure)[14] 和行为方法(behavioral approach)[15]。大多数多智能体编队控制研究采用领航-跟随结构,其中部分无人机设为领航机,其余为跟随机。这一方法易于理解与实现,但对领航机故障不具备鲁棒性。尽管虚拟领航者策略被提出以提升鲁棒性,但链式结构导致其抗扰能力较差 [13]。在虚拟结构方法中,将整个编队视为一个虚拟刚体结构。各个无人机不是跟踪轨迹,而是跟踪一个运动点,从而允许虚拟结构与另一无人机相连接 [12]。由于编队内所有智能体被视作单一对象,群体的引导比其他方法更为容易。但编队只能实现同步机动,且难以考虑避障问题 [16]。行为方法则为每架无人机设计若干期望行为,包括保持队形、目标追踪和防碰撞/避障。每架无人机的控制动作是各行为控制的加权平均 [17]。该方法适用于不确定环境,但缺乏严格的理论分析。
基于MPC的多无人机编队控制问题已被广泛研究,如 [18-21]。在 [20] 中,采用了双模MPC方法实现机器人编队控制。为了保证系统稳定性,双模控制器需在MPC控制与终端状态控制之间切换。部分学者专门研究了MPC方法下的无人机编队飞行问题 [22-28]。其中,[22,24] 主要研究了紧密编队飞行问题,[25-28] 仅在MPC问题建模中采用了无人机线性动力学模型。[23] 在MPC建模中采用了无人机非线性动力学模型和领航-跟随结构进行编队飞行控制器设计,利用Karush-Kuhn-Tucker (KKT) 变量实现防碰撞机动,但需要动态选择合适变量以平衡轨迹跟踪与防碰撞之间的权衡。
序贯二次规划(Sequential Quadratic Program, SQP)是求解非线性规划(NLP)问题最有效的方法之一。它采用罚函数或优值函数以促进全局收敛性。然而,在实际应用中通常难以选择合适的罚参数。为避免罚参数设置带来的实际问题,Fletcher 和 Leyffer [29] 引入了一种SQP信赖域算法的过滤器,以提升全局收敛性。
本文中,我们在非线性MPC框架下设计了一种分布式无人机编队飞行控制律。采用虚拟参考点控制策略以确定编队形态。
在本文中,我们在非线性MPC框架下设计了一种分布式无人机编队飞行控制律。采用虚拟参考点控制策略来确定编队构型。本文的主要贡献在于,通过新的代价惩罚项实现了避障保障。机间防碰撞则通过代价函数与优先级策略相结合,并利用延迟的邻居信息来实现。为简化问题,假设编队飞行中所用的所有数据均未受到过程噪声和测量噪声的影响。
本文其余部分安排如下:第2节给出了问题的形式化描述。第3节设计了基于非线性模型预测控制的无碰撞编队飞行控制律。第4节展示了仿真结果,并在性能方面将本算法与其他方法进行了对比。最后,第5节给出了总结与未来工作展望。
2. 问题描述
2.1. 二维无人机动力学模型
一种常见的无人机控制系统是双环结构,其中姿态动力学由内环控制,位置动力学由外环控制。在编队飞行的多无人机群体背景下,外环还包含一个能够实现并保持给定编队构型的控制器。为简化分析,本文分析了无人机在水平平面内的二维运动 [30],并将无人机的内环动力学建模为一阶模型:
$$ \begin{gather*} \dot{x}_{i}=v_{i} \sin \psi_{i} \\ \dot{y}_{i}=v_{i} \cos \psi_{i} \\ \dot{\psi}_{i}=\frac{g \tan \gamma_{i}}{v_{i}} \tag{2.1}\\ \dot{v}_{i}=\frac{1}{\alpha_{v}}\left(v_{i}^{c}-v_{i}\right) \\ \dot{\gamma}_{i}=\frac{1}{\alpha_{\gamma}}\left(\gamma_{i}^{c}-\gamma_{i}\right) \end{gather*} $$其中,$\left(x_{i}, y_{i}\right), \psi_{i}, v_{i}$ 和 $\gamma_{i}$ 分别为无人机 $i$ 的惯性位置、航向角、速度和滚转角。$v_{i}^{c}$ 和 $\gamma_{i}^{c}$ 分别为下发给无人机 $i$ 自动驾驶仪的指令速度和滚转角;$g$ 为重力常数。$\alpha_{v}$ 和 $\alpha_{\gamma}$ 为正数常量。
通常,无人机编队飞行时会有一个参考轨迹。动力学与运动学约束限制了无人机无法跟踪任意参考轨迹。借鉴文献 [31],我们假设编队飞行轨迹生成器生成的参考轨迹满足以下方程:
$$ \begin{gather*} \dot{x}_{r}=v_{r} \cos \psi_{r} \\ \dot{y}_{r}=v_{r} \sin \psi_{r} \tag{2.2}\\ \dot{\psi}_{r}=w_{r} \end{gather*} $$其中 $v_{r}$ 和 $w_{r}$ 为分段连续且一致有界的量,满足以下约束条件:
$$ \begin{gather*} 0 < v_{\min } \leq v_{r} \leq v_{\max }, \\ \left|w_{r}\right| \leq w_{\max } . \tag{2.3} \end{gather*} $$2.2. 编队控制策略
本文采用虚拟点跟踪策略实现期望编队。假设存在一个运动的参考点,代表一架无人机跟踪预设参考轨迹。每架无人机可通过无线通信提前或在飞行过程中获知该参考点的实时运动信息。每架无人机需尽量保持与该参考点的规定相对距离与角度。从本质上看,该方法类似于虚拟领航者方法,但不存在无人机之间的误差传递。
如图1所示,参考点坐标系 $X_{r} O_{r} Y_{r}$ 固定在参考点 $O_{r}$ 上。它由参考点的位置和速度方向唯一确定。编队构型可在 $X_{r} O_{r} Y_{r}$ 坐标系下定义。每架无人机的期望位置可通过下式确定:
$$ \left[\begin{array}{l} x_{i}^{d} \tag{2.4}\\ y_{i}^{d} \end{array}\right]=\left[\begin{array}{l} x_{r} \\ y_{r} \end{array}\right]+\left[\begin{array}{cc} \cos \psi_{r} & \sin \psi_{r} \\ -\sin \psi_{r} & \cos \psi_{r} \end{array}\right]\left[\begin{array}{l} x_{i}^{d r} \\ y_{i}^{d r} \end{array}\right], $$其中 $\left(x_{r}, y_{r}\right)$ 和 $\psi_{r}$ 分别为虚拟参考点在 $X O Y$ 坐标系下的坐标与航向角。
2.3. 控制目标
考虑一个由 $N_{v}$ 架同质无人机构成的编队。为简化记号,我们可将第 $i$ 架无人机的动力学模型表示为如下非线性离散状态空间形式:
$$ \begin{equation*} \mathbf{x}_{i}(k+1)=f\left(\mathbf{x}_{i}(k), \mathbf{u}_{i}(k)\right), \tag{2.5} \end{equation*} $$其中,$\mathbf{x}_{i}(k)=\left[x_{i}(k), y_{i}(k), v_{i}(k), \psi_{i}(k)\right]^{\mathrm{T}}$,$\mathbf{u}_{i}(k)=\left[v_{i}^{c}(k), \gamma_{i}^{c}(k)\right]^{\mathrm{T}}$,分别为第 $i$ 架无人机在时刻 $k$ 的状态与控制输入,$f$ 为非线性连续函数。
定义第 $i$ 架无人机的跟踪状态误差向量与控制输入误差向量为
$$ \begin{equation*} \mathbf{x}_{e i}(k)=\mathbf{x}_{i}(k)-\mathbf{x}_{i}^{d}(k) \tag{2.6} \end{equation*} $$其中 $\mathbf{x}_{i}^{d}(k)=\left[x_{i}^{d}(k), y_{i}^{d}(k), v_{r}(k), \psi_{r}(k)\right]^{\mathrm{T}}$。
因此,无人机编队飞行问题可以转化为寻找使得如下条件成立的控制律:
$$ \begin{equation*} \mathbf{x}_{e i}(k) \rightarrow \mathbf{0}, \quad i=1, \ldots, N_{v} . \tag{2.7} \end{equation*} $$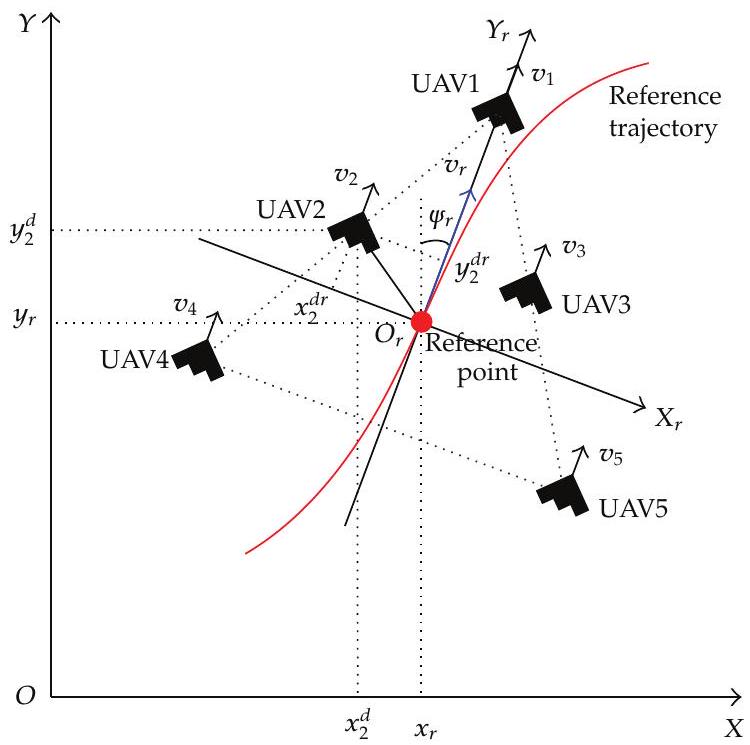
图1:参考点坐标系 $\mathrm{XrOr} \Upsilon r$ 下的编队定义。
3. 控制定律设计
MPC方法的核心思想是通过反复在线求解最优控制问题来获得控制动作。由于每架无人机都具备计算能力,因此可以在MPC框架下设计分布式编队飞行控制律。每架无人机根据自身局部状态以及邻近无人机的状态信息,计算自身的控制输入。
3.1. 虚拟点跟踪
由式(2.5)可知,第 $i$ 架无人机对自身动力学的预测可表示为
$$ \begin{equation*} \mathbf{x}_{i}(k+s+1 \mid k)=f\left(\mathbf{x}_{i}(k+s \mid k), \mathbf{u}_{i}(k+s \mid k)\right), \quad s=0, \ldots, N-1, \tag{3.1} \end{equation*} $$其中,$N$ 为预测时域,$\mathbf{x}*{i}(k+s \mid k)$ 表示第 $i$ 架无人机在 $k+s$ 时刻(以 $k$ 为基准)预测的状态,且 $\mathbf{x}*{i}(k \mid k)=\mathbf{x}*{i}(k)$。相应地,$\mathbf{u}*{i}(k+s \mid k)$ 表示在 $k+s$ 时刻预测的控制输入,$\mathbf{u}*{i}(k \mid k)=\mathbf{u}*{i}(k)$。
首先,在不考虑避障和机间防碰撞问题时,时刻 $k$ 的代价函数定义为
$$ \begin{align*} J_{N}\left(\mathbf{x}_{i}, \mathbf{u}_{i}, k\right)= & \sum_{s=1}^{N-1}\left(\mathbf{x}_{e i}^{\mathrm{T}}(k+s \mid k) \mathbf{Q} \mathbf{x}_{e i}(k+s \mid k)+\mathbf{u}_{e i}^{\mathrm{T}}(k+s-1 \mid k) \mathbf{P} \mathbf{u}_{e i}(k+s-1 \mid k)\right) \tag{3.2}\\ & +\mathbf{x}_{e i}^{\mathrm{T}}(k+N \mid k) \mathbf{Q}_{N} \mathbf{x}_{e i}(k+N \mid k), \end{align*} $$其中,$\mathbf{Q}, \mathbf{P}, \mathbf{Q}*{N}$ 均为正定对称矩阵,$\mathbf{u}_{e i}(k)=\mathbf{u}_{i}(k)-\mathbf{u}_{i}^{d}(k)$。
3.2. 避障
在障碍物丰富的环境中,无人机必须具备自动避障能力。传统上,直接在MPC优化问题中加入不等式约束以实现避障 [24]。这种建模方法较为简单,但由于其非凸性,求解难度较大。此外,这类基于距离的避障方法常导致不必要的规避和频繁的机动。
在此,本文提出了一种新的有效避障方法。如图2所示,当无人机与障碍物的最短距离小于危险距离 $l_{D}$ 时,利用无人机的位置与速度方向预测其与障碍物在近期内的最小允许距离 $l_{M}$ 是否会被突破。若会,则在无人机的目标函数中加入一个代价项,并驱使无人机进行避障,同时保证其不会偏离之前的期望轨迹过远,从而实现编队。为简化分析,本文仅考虑静态且圆形障碍物,并假设障碍物的位置和半径可以实时获得。
时刻 $k$,第 $i$ 架无人机的避障代价函数定义为
$$ L_{o}\left(\mathbf{x}_{i}, k\right)=\left\{\begin{array}{l} 0 \quad \text { if } l_{i}^{s}(k) \geq l_{D}, \tag{3.3}\\ 0 \quad \text { if } l_{i}^{s}(k) < l_{D},\ l_{i}^{s p}(k) \geq l_{M}, \\ \sum_{s=1}^{N}-a\left(l_{i}^{s}(k+s \mid k)-l_{M}\right) \quad \text { if } l_{i}^{s}(k) < l_{D},\ l_{i}^{s p}(k) < l_{M}, \end{array}\right. $$其中
$$ \begin{align*} l_{i}^{s}(k) & =\sqrt{\left(x_{i}(k)-x_{o}\right)^{2}+\left(y_{i}(k)-y_{o}\right)^{2}}-R_{o}, \\ l_{i}^{s}(k+s \mid k) & =\sqrt{\left(x_{i}(k+s \mid k)-x_{o}\right)^{2}+\left(y_{i}(k+s \mid k)-y_{o}\right)^{2}}-R_{o}, \tag{3.4}\\ l_{i}^{s p}(k) & =\frac{\left|\cot \left(\psi_{i}(k)\right)\left(x_{o}-x_{i}(k)\right)+\left(y_{o}-y_{i}(k)\right)\right|}{\sqrt{\left(\cot \left(\psi_{i}(k)\right)\right)^{2}+1}} . \end{align*} $$$l_{D}, l_{M}$ 为正数常量,$a$ 为正参数。$(x_{o}, y_{o})$ 和 $R_{o}$ 分别为障碍物的笛卡尔坐标与半径。
3.3. 机间防碰撞
机间防碰撞也是编队飞行中的一个重要方面。与避障问题类似,一些文献在MPC框架下通过在优化问题中加入不等式约束来确保防碰撞 [23]。然而,过多的约束通常会使优化问题难以求解,尤其是在大规模编队飞行应用中。此外,参与防碰撞的无人机可能会同时机动以规避碰撞,这会导致编队中出现不希望的链式反应,特别是在紧密编队飞行时。
本文提出了一种基于代价函数和优先级策略的新方法来确保机间防碰撞。首先,在每个采样时刻,根据无人机当前的相对位置和任务,对涉及防碰撞的无人机赋予优先级。
在此,本文提出了一种通过代价函数结合优先级策略来实现机间防碰撞的新方法。首先,在每个采样时刻,根据无人机的当前相对位置和任务,对涉及防碰撞的无人机分配优先级。当两架无人机的相对距离小于安全分隔距离时,优先级较低的无人机应将优先级较高的无人机视为运动障碍物进行规避。该策略能够避免不必要的链式机动,因为参与防碰撞机动的无人机数量更少。
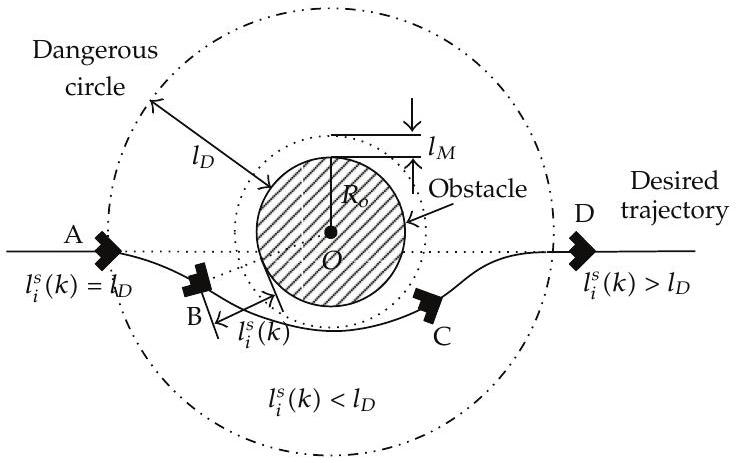
图2:跟踪轨迹过程中的静态障碍物避障。
优先级分配规则如下:
- 跟踪误差较小的无人机优先级高于跟踪误差较大的无人机;
- 有紧急任务(如避障)的无人机拥有最高优先级。
与避障不同,我们假设每架无人机都拥有一个半径为 $d_{D}$ 的圆形保护区和一个半径为 $d_{M}$ 的圆形碰撞区,如图3所示。当两架无人机的保护区发生交叠时,优先级较低的无人机应将另一架无人机视为运动障碍物进行规避。当两架无人机的碰撞区发生交叠时,则会发生碰撞。
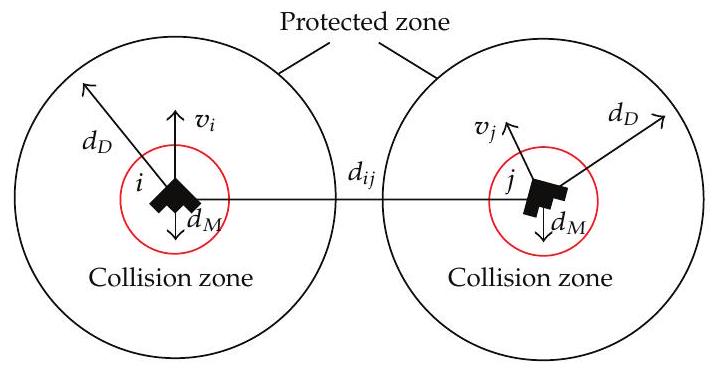
图3:无人机的保护区和碰撞区。
本文假设机间无线通信网络始终可用,但在信息流中会引入随机时延 $d_{k}$。假设 $d_{k}$ 有界,即
$$ \begin{equation*} 0 \leq d_{k} \leq d_{\max } . \tag{3.5} \end{equation*} $$因此,在时刻 $k$,第 $i$ 架无人机可以获取到第 $j$ 架无人机在 $k-d_{k}$ 时刻预测的未来位置向量,即 $\left(x_{j}\left(k+s \mid k-d_{k}\right), y_{j}\left(k+s \mid k-d_{k}\right)\right),\ s=1, \ldots, N$。
第 $i$ 架无人机的机间防碰撞代价函数定义为
$$ L_{p}\left(\mathbf{x}_{i}, k\right)=\left\{\begin{array}{l} 0 \quad \text { if } d_{i j}(k) \geq 2 d_{D}, \tag{3.6}\\ 0 \quad \text { if } d_{i j}(k) < 2 d_{D},\ p_{i}(k) > p_{j}(k), \\ \sum_{s=1}^{N}-b\left(d_{i j}(k+s \mid k)-2 d_{D}\right) \quad \text { if } d_{i j}(k) < 2 d_{D},\ p_{i}(k) < p_{j}(k), \end{array}\right. $$其中
$$ \begin{gather*} d_{i j}(k)=\sqrt{\left(x_{i}(k)-x_{j}\left(k \mid k-d_{k}\right)\right)^{2}+\left(y_{i}(k)-y_{j}\left(k \mid k-d_{k}\right)\right)^{2}} \\ d_{i j}(k+s \mid k)=\sqrt{\left(x_{i}(k+s \mid k)-x_{j}\left(k+s \mid k-d_{k}\right)\right)^{2}+\left(y_{i}(k+s \mid k)-y_{j}\left(k+s \mid k-d_{k}\right)\right)^{2}} \tag{3.7} \end{gather*} $$$d_{D}, d_{M}$ 为正数常量,$b$ 为正参数,$p_{i}(k), p_{j}(k)$ 分别为时刻 $k$ 下第 $i$ 架和第 $j$ 架无人机的优先级。
由于在时刻 $k$,第 $i$ 架无人机只能获得第 $j$ 架无人机从 $k-d_{k}$ 到 $k-d_{k}+N$ 时刻的预测位置,因此 $j$ 号无人机从 $k-d_{k}+N+1$ 到 $k+N$ 的位置应由 $i$ 号无人机根据延迟信息进行递推。
为简化处理,采用线性递推方法预测第 $j$ 架无人机从 $k-d_{k}+N+1$ 到 $k+N$ 时刻的位置,具体如下:
$$ \left[\begin{array}{l} x_{j}\left(k-d_{k}+N+s\right) \tag{3.8}\\ y_{j}\left(k-d_{k}+N+s\right) \end{array}\right]=2\left[\begin{array}{l} x_{j}\left(k-d_{k}+N-1+s\right) \\ y_{j}\left(k-d_{k}+N-1+s\right) \end{array}\right]-\left[\begin{array}{l} x_{j}\left(k-d_{k}+N-2+s\right) \\ y_{j}\left(k-d_{k}+N-2+s\right) \end{array}\right], \quad s=1, \ldots, d_{k} $$所有无人机的优先级应以分布式方式计算。由于存在随机通信时延,第 $i$ 架无人机根据邻近的第 $j$ 架无人机的距离误差向量 $e_{j}\left(k \mid k-d_{k}\right)$ 及自身当前距离误差 $e_{i}(k \mid k)$ 来计算优先级。
3.4. 优化问题
为实现无碰撞编队飞行,时刻 $k$,第 $i$ 架无人机需求解如下优化问题:
$$ \begin{equation*} \mathbf{u}_{i}^{*}=\arg \min _{\mathbf{u}_{i}}\left\{J_{N}\left(\mathbf{x}_{i}, \mathbf{u}_{i}, k\right)+L_{o}\left(\mathbf{x}_{i}, k\right)+L_{p}\left(\mathbf{x}_{i}, k\right)\right\} \tag{3.9} \end{equation*} $$表1:每架无人机的控制输入约束。
| $v_{\text {max }}$ | $200,\mathrm{~m} / \mathrm{s}$ |
|---|---|
| $v_{\text {min }}$ | $100,\mathrm{~m} / \mathrm{s}$ |
| $\left\|\dot{v}_{\text {max }}\right\|$ | $20,\mathrm{~m} / \mathrm{s}$ |
| $\gamma_{\text {max }}$ | $30^\circ$ |
| $\gamma_{\text {min }}$ | $-30^\circ$ |
| $\left\|\dot{\gamma}_{\text {max }}\right\|$ | $20,\mathrm{deg} / \mathrm{s}$ |
| $\alpha_{v}$ | $3.2,\mathrm{s}$ |
| $\alpha_{r}$ | $0.6,\mathrm{s}$ |
约束条件为
$$ \begin{gather*} \mathbf{x}_{i}(k+s+1 \mid k)=f\left(\mathbf{x}_{i}(k+s \mid k), \mathbf{u}_{i}(k+s \mid k)\right) \\ \mathbf{x}_{i}(k+s \mid k) \in \mathcal{X}_{i},\ \mathbf{u}_{i}(k+s \mid k) \in \mathcal{U}_{i} \tag{3.10}\\ s=0, \ldots, N-1 \end{gather*} $$在当前采样周期,将最优输入应用于第 $i$ 架无人机。在 $k+1$ 时刻,使用更新后的信息和移动的时域,重复上述流程。
4. 仿真
为验证所设计编队飞行控制律的可行性与有效性,本文进行了仿真实验。要求5架无人机从随机初始位置达到期望编队构型,并在跟踪编队参考轨迹的同时保持该构型。整个过程中需始终确保防碰撞和避障。仿真在MATLAB环境下进行,优化问题通过TOMLAB中的filterSQP函数求解 [32]。
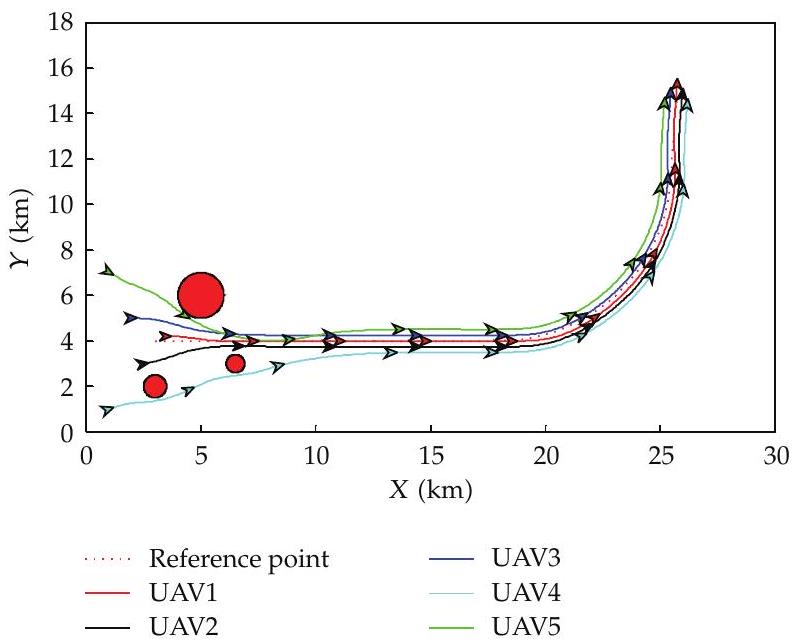
图4:无人机编队实现与保持的仿真结果。
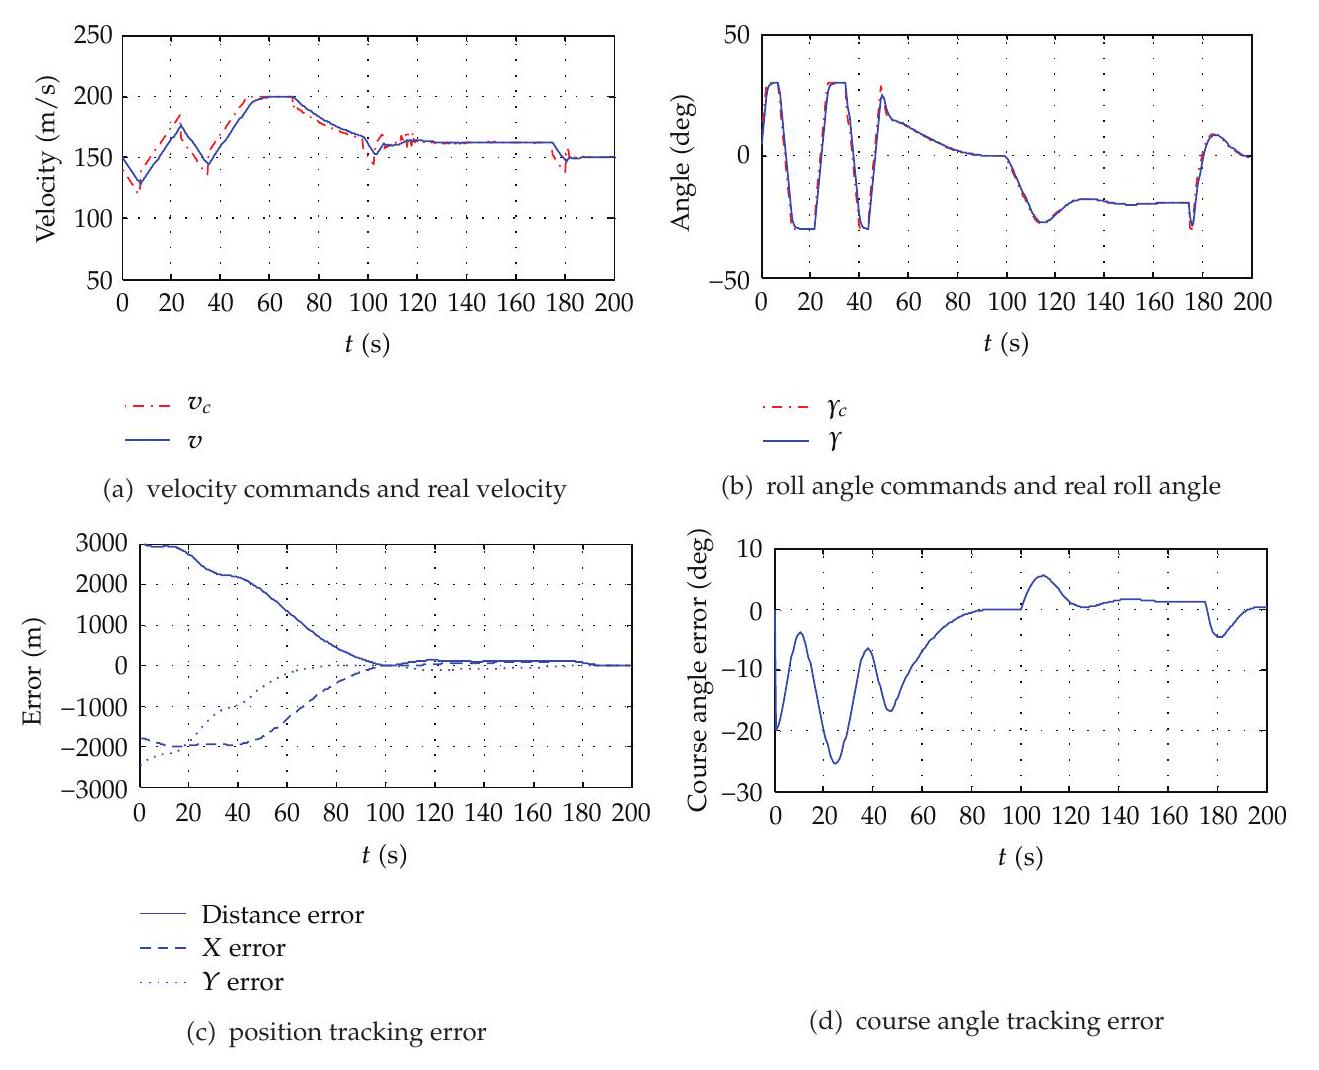
图5:UAV4的控制输入与跟踪误差历史。
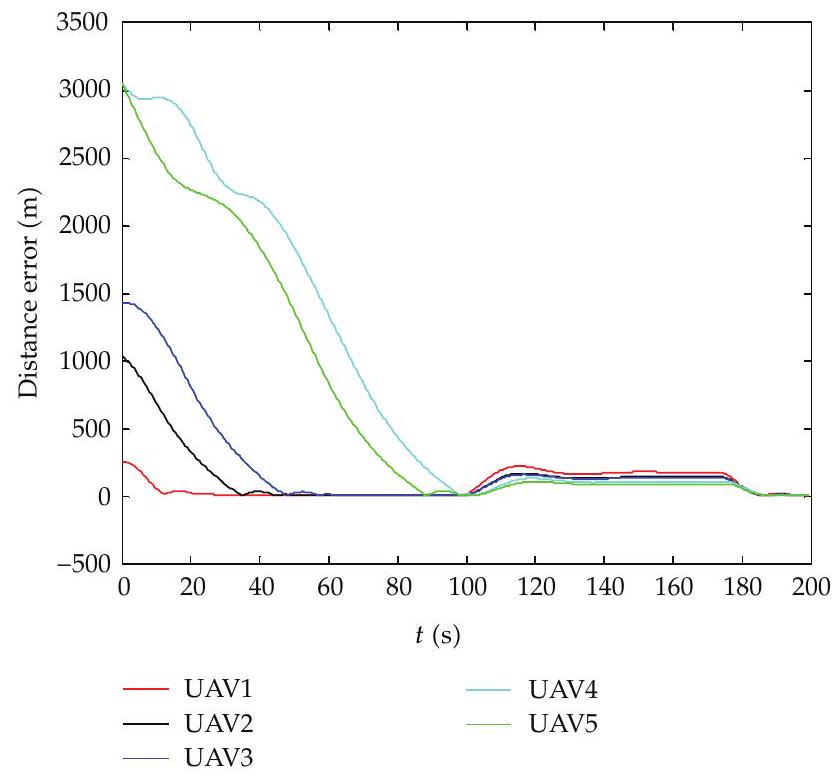
图6:各无人机的距离误差历史。
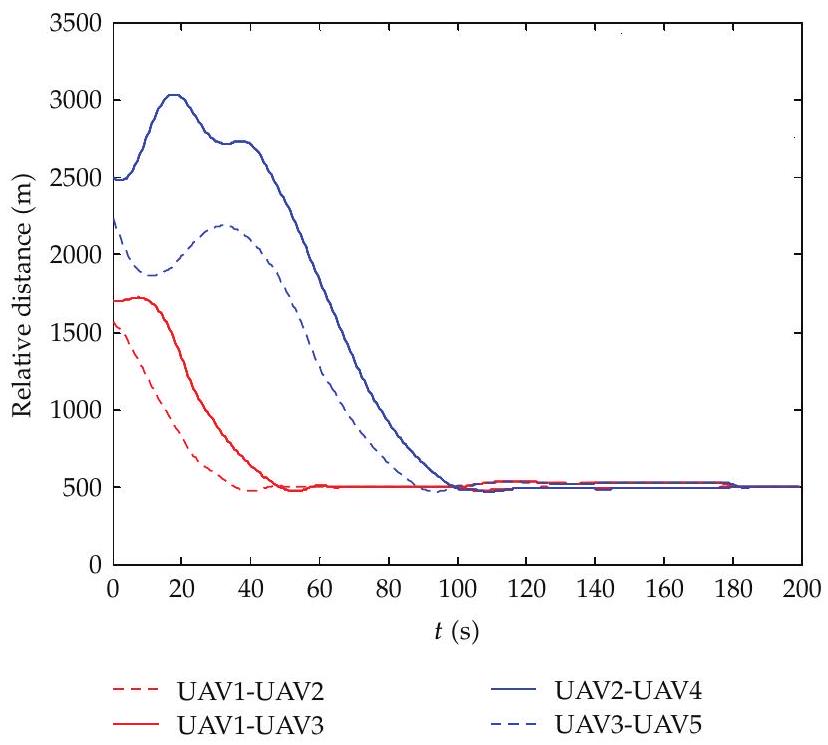
图7:无人机间相对距离历史。
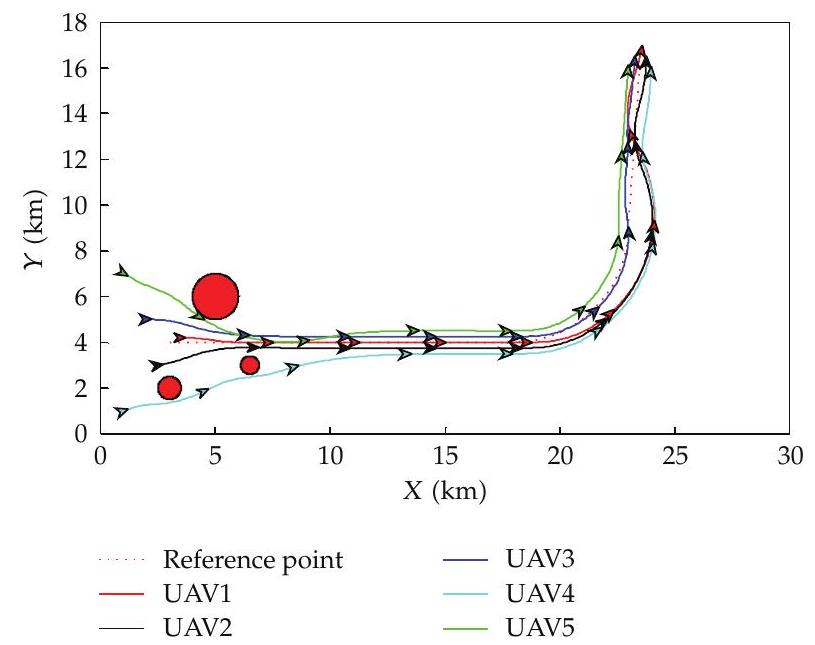
图8:五架无人机急转弯下的轨迹($w_{r}=-0.03 \mathrm{rad} / \mathrm{s},\ t \in 100,\mathrm{s},\ 150,\mathrm{s}$)。
4.1. 仿真参数
总仿真时长为200秒。MPC的预测时域和控制时域分别取 $N=5$ 和 $T_{S}=0.5,\mathrm{s}$。
期望无人机编队构型为箭头型,其虚拟点在虚拟参考点坐标系下分别为 ${(0,0.577),(-0.25,0.144),(0.25,0.144),(-0.5,-0.288),(0.5,-0.288)}$。有三个静态障碍物,分别位于 $[5,6],[3,2]$ 和 $[6.5,3]$,半径分别为 $1,\mathrm{km}$、$0.5,\mathrm{km}$ 和 $0.4,\mathrm{km}$。$d_{M}=0.02,\mathrm{km},\ d_{D}=0.2,\mathrm{km},\ l_{D}=2,\mathrm{km},\ l_{M}=100,\mathrm{m},\ d_{\text{max}}=2,\ a=1000,\ b=1000,\ w_{r}=0.035,\mathrm{rad}/\mathrm{s}$(见表1)。
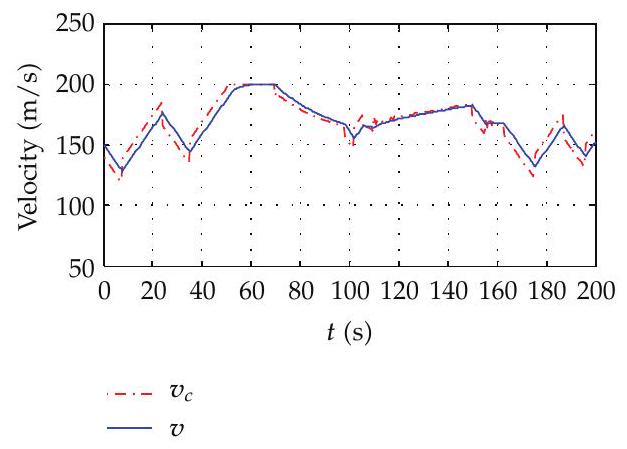
(a) 速度指令与实际速度
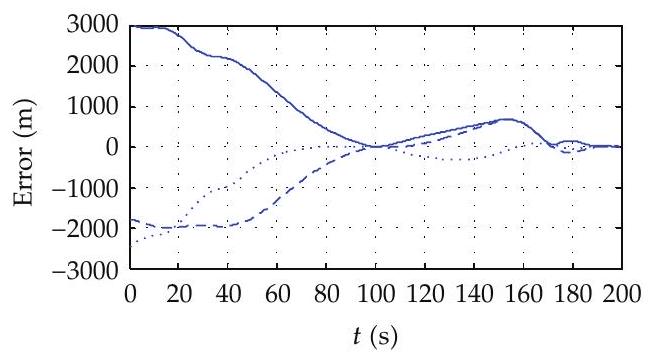
- 距离误差 -– X误差 $Y$误差 (c) 位置跟踪误差
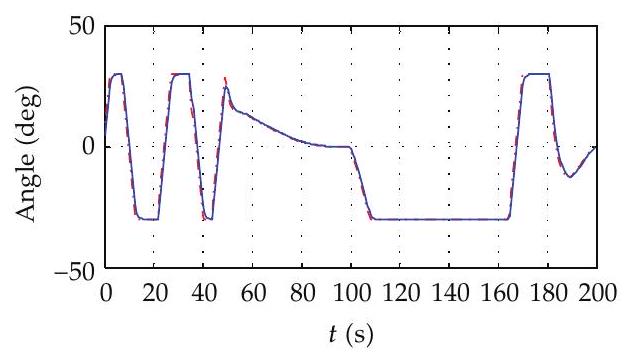
(b) 滚转角指令与实际滚转角
(d) 航向角跟踪误差
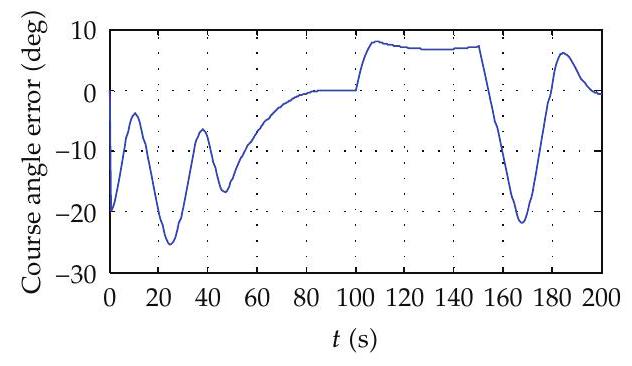
图9:急转弯条件下UAV4的控制输入与跟踪误差历史。
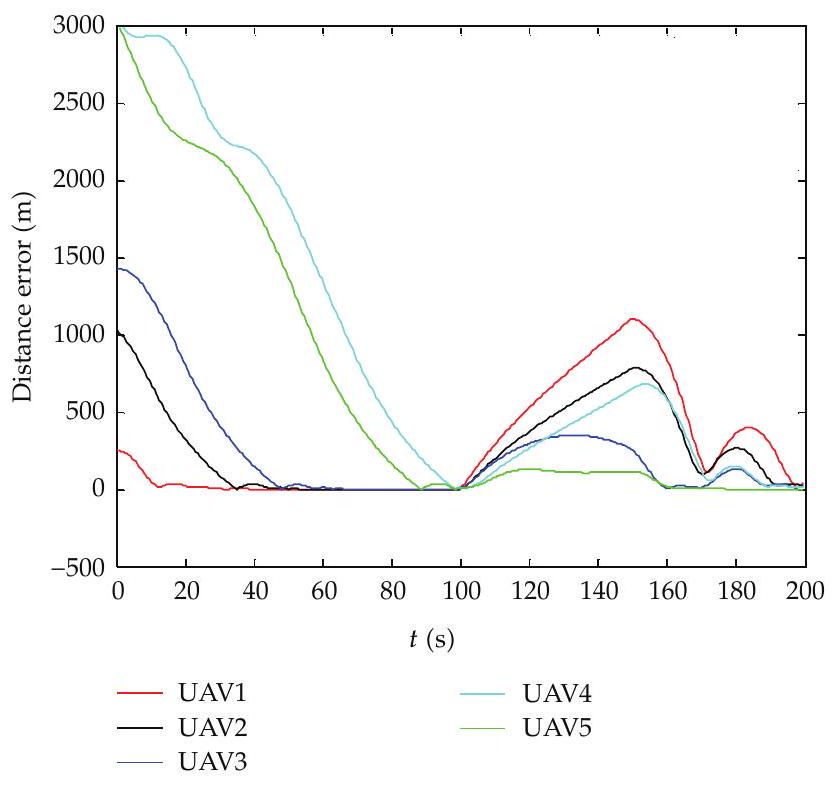
图10:急转弯条件下各无人机的距离误差历史。
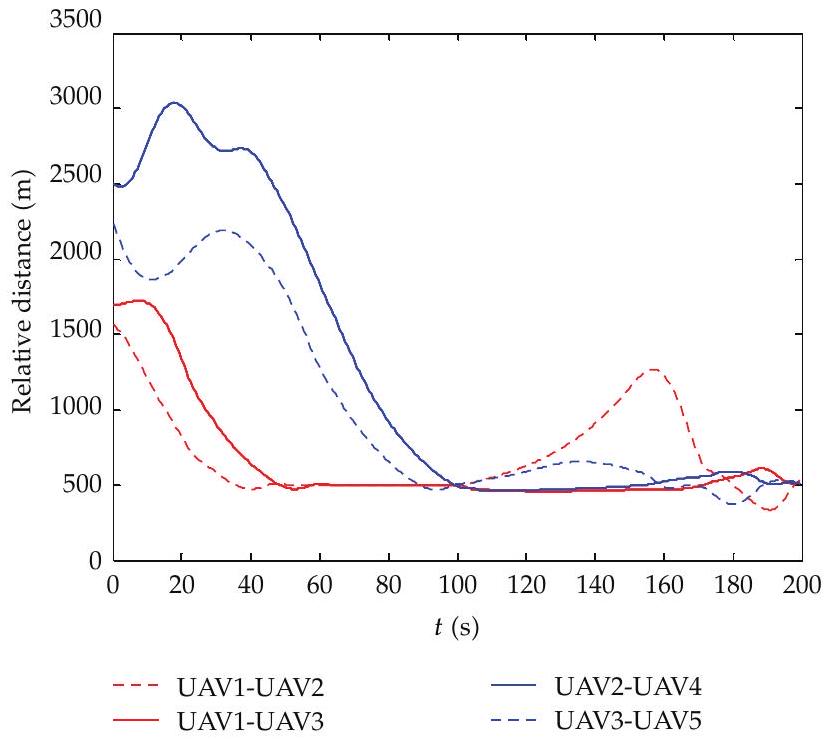
图11:急转弯条件下无人机间相对距离历史。
参考点的参考轨迹为 $\left(x_{r 0}, y_{r 0}\right)=[3,4],\ \psi_{r 0}=90^{\circ},\ v_{r 0}=150,\mathrm{m}/\mathrm{s},\ v_{r}=150,\mathrm{m}/\mathrm{s},\ t \in[0,200],\mathrm{s}$
$$ w_{\mathrm{r}}= \begin{cases}0(\mathrm{rad}/\mathrm{s}), & t \in[0,100]\,\mathrm{s} \tag{4.1}\\ 0.02(\mathrm{rad}/\mathrm{s}), & t \in(100,175]\,\mathrm{s} \\ 0(\mathrm{rad}/\mathrm{s}), & t \in(175,200]\,\mathrm{s}\end{cases} $$4.2. 仿真结果
图4显示,5架无人机大约在100秒内能会聚至期望六边形编队。图中箭头显示了各无人机在$0,25,50,75,100,125,150,175,200$秒时刻的位置和航向。在编队形成过程中,UAV4能自动避开两个障碍物。编队完成后,无人机能够跟踪编队参考轨迹,并在机动过程中保持编队构型。图5展示了UAV4的控制输入指令和跟踪误差历史。可见控制输入均受约束限制,跟踪误差能逐步收敛至零。图6为各无人机的距离误差,图7为无人机间相对距离。仿真结果表明,所设计的基于MPC的编队飞行控制律能在障碍物密集环境下良好工作。
图8显示,在急转弯过程中编队构型无法保持。由于控制输入本身存在饱和约束,部分无人机无法以规定偏移量跟踪虚拟参考点。图9-11进一步显示,虽然UAV4的滚转角已达到极值,但在急转弯过程中其角速度无法达到期望状态。
5. 结论与未来工作
本文在MPC框架下设计了一种无碰撞无人机编队飞行控制器。编队构型在虚拟参考点坐标系中确定,该坐标系由虚拟参考点的位置和速度方向唯一确定。随后,在MPC框架下设计了分布式编队飞行控制律,充分考虑了无人机的非线性动力学模型、状态和控制输入约束。避障通过代价惩罚项予以保障,机间防碰撞则通过碰撞代价惩罚项,结合延迟邻居信息与新的优先级策略实现。仿真结果表明,所设计的控制器能够在避障与机间防碰撞的同时,实现对期望参考轨迹的编队会聚与保持。未来工作将进一步研究通信延迟对所提编队飞行控制器及编队重构控制问题的影响。
附:非线性规划(NLP)求解器的选择
在模型预测控制(MPC)中,每一步都需要在线求解一个优化问题,因此选择一个高效、可靠的非线性规划(NLP)求解器至关重要,尤其是在需要满足实时控制要求的无人机集群控制任务中。论文中也提到,序列二次规划(SQP)是解决非线性规划问题最有效的方法之一。
考虑到您任务的实时性需求(通常无人机MPC的控制周期在几十到几百毫秒)以及MPC问题的特性(非线性动力学、非线性代价函数、状态和控制约束、相对较小的优化变量维度,例如预测时域N=5时,控制输入为2维,则优化变量为10维),以下是一些适合的快速NLP求解器推荐:
IPOPT (Interior Point Optimizer)
- 优点:
- 开源(Eclipse Public License - EPL),免费使用。
- 为大规模非线性规划设计,但对中小型问题也表现优异。
- 鲁棒性好,广泛应用于学术界和工业界。
- 提供C++接口,易于集成。
- 支持精确的二阶导数(Hessian矩阵)或拟牛顿法(如L-BFGS)近似。
- 支持稀疏矩阵表示,对大规模问题有利(对您当前问题规模可能不那么关键,但仍是良好实践)。
- 支持热启动(Warm Start),这对于MPC非常重要,因为每个时间步的优化问题都与上一步相似,使用前一步的解作为初始猜测可以显著加速收敛。
- 缺点:
- 作为内点法求解器,对于某些特定结构或非常小规模的问题,可能不如专门的SQP求解器快。
- 需要提供目标函数、约束及其梯度(Jacobian矩阵),最好也能提供Hessian矩阵(或其结构)以获得最佳性能。可以使用自动微分工具(如CppAD, ADOL-C)辅助生成。
- 适用性: 对于您描述的MPC问题,IPOPT是一个非常好的通用选择,特别是如果您能提供精确的梯度和Hessian信息(或使用其L-BFGS近似)。
- 优点:
NLopt
- 优点:
- 开源(主要是MIT/LGPL等自由许可证)。
- 一个包含多种优化算法的库,既有全局优化也有局部优化算法,有基于梯度的也有无梯度的。
- 对于基于梯度的局部优化,它包含了如SLSQP(Sequential Least Squares Programming,一种SQP算法)、L-BFGS、MMA等。SLSQP通常对有约束的非线性优化问题表现良好且速度较快。
- 轻量级,C/C++接口友好。
- 允许用户灵活选择和切换不同的优化算法。
- 缺点:
- 性能和鲁棒性因所选具体算法而异。需要针对问题特性选择合适的算法。
- 某些算法可能不如IPOPT或SNOPT等专用大规模求解器在复杂问题上鲁棒。
- 适用性: NLopt中的SLSQP算法是实现SQP的一个很好选择,符合论文中提到的SQP方法,并且通常对于中小型NLP问题速度很快。
- 优点:
OSQP (Operator Splitting Quadratic Program solver) / qpOASES (online active set QP solver) - 作为SQP子问题求解器
- 优点:
- 这两个都是非常高效的二次规划(QP)求解器,专为MPC等嵌入式应用优化,速度极快,代码量小。
- 开源,具有良好的实时性能和鲁棒性。
- 支持热启动。
- 缺点:
- 它们本身是QP求解器。要解决NLP问题,您需要自己实现SQP算法的框架(即在每次迭代中线性化非线性问题得到QP子问题,然后调用OSQP或qpOASES求解该QP)。这增加了实现的复杂度。
- 需要自己处理全局化策略(如线搜索或信任域)。
- 适用性: 如果您愿意投入更多精力实现SQP框架(这能提供对算法的极致控制并可能达到最佳性能),那么使用OSQP或qpOASES作为QP子问题的求解器是非常理想的选择。这与论文中强调SQP方法有效性的观点一致。
- 优点:
CasADi (配合上述求解器)
- 优点:
- 一个强大的开源符号计算和自动微分工具,非常适合复杂优化问题的建模。
- 可以清晰地定义优化问题,并自动计算所需的高阶导数。
- 能够将优化问题接口到多种NLP求解器后端,包括IPOPT、SNOPT、OSQP、qpOASES等。
- 可以将整个优化问题(包括模型、代价函数、约束)转换为高效的C代码,然后与求解器链接,从而获得很高的执行速度。
- 缺点:
- 学习曲线相对陡峭。
- 增加了额外的依赖和抽象层。
- 适用性: 如果追求极致性能和灵活性,并且愿意投入时间学习,CasADi结合一个快速的后端求解器(如IPOPT或基于QP的SQP)是非常强大的组合。它可以帮助您轻松处理非线性动力学和代价函数的导数计算。
- 优点:
选择建议与实时性考量:
- 直接集成: 对于快速原型和良好的通用性能,IPOPT 或 NLopt (使用SLSQP) 是不错的起点。它们相对容易集成,并且有大量文档和社区支持。
- 追求极致性能: 如果对性能有极致要求,且愿意进行更底层的开发,可以考虑:
- 自己实现SQP框架,并使用 OSQP 或 qpOASES 作为QP求解器。
- 使用 CasADi 来构建模型和生成代码,后端连接 IPOPT 或上述QP求解器。
为了满足实时控制要求,无论选择哪个求解器,都需要注意以下几点:
- 解析导数: 尽可能提供目标函数和约束的解析梯度(Jacobian)和Hessian矩阵。如果手动推导困难,可以使用自动微分工具(如CasADi内置的,或独立的如CppAD)。这通常比求解器内部的有限差分近似快得多且准确。
- 热启动 (Warm Starting): MPC的连续优化问题之间相似性很高。利用上一时间步的解(或稍作调整的解)作为当前优化的初始猜测,可以显著减少求解器的迭代次数和计算时间。大多数现代求解器都支持此功能。
- 问题规模控制: 保持预测时域
N在满足性能要求的前提下尽可能小。您的N=5是一个比较合理的选择。 - 代码优化: 确保您在C++中实现的目标函数、约束及其导数计算本身是高效的,避免不必要的计算和内存分配。
- 求解器参数调整: 大多数求解器都有很多参数可以调整(如收敛容差、最大迭代次数等)。根据您的具体问题和实时性要求进行调整,可能需要在求解精度和求解时间之间做一些权衡。
- 算法选择 (如使用NLopt): 如果使用NLopt这样的库,仔细选择内部的具体算法至关重要。
考虑到论文中提及filterSQP 并强调SQP的有效性,选择一个基于SQP的求解器(如NLopt中的SLSQP)或实现一个SQP框架可能是与论文思路最为接近的。然而,IPOPT作为一款成熟的内点法求解器,在实际应用中也常常能提供非常有竞争力的性能。建议您可以先尝试IPOPT或NLopt中的SLSQP,评估其在您平台上的实际运行时间和鲁棒性。
Acknowledgment
Research is supported by the National Science Foundation of China (NSFC) under Grant no. 6001203.
References
[1] A. Ryan, M. Zennaro, A. Howell, R. Sengupta, and J. K. Hedrick, “An overview of emerging results in cooperative UAV control,” in Proceedings of the 43rd IEEE Conference on Decision and Control, vol. 1, pp. 602-607, Atlantis, Bahamas, 2004.
[2] Y. Zou, P. R. Pagilla, and R. T. Ratliff, “Distributed formation flight control using constraint forces,” Journal of Guidance, Control, and Dynamics, vol. 32, no. 1, pp. 112-120, 2009.
[3] A. W. Proud, M. Pachter, and J. D. A. John, Close Formation Flight Control, 1999.
[4] T. Paul, T. R. Krogstad, and J. T. Gravdahl, “UAV formation flight using 3D potential field,” in Proceedings of the 16th Mediterranean Conference on Control and Automation, pp. 1240-1245, June 2008.
[5] M. Suzuki, K. Uchiyama, D. J. Bennet, and C. R. McInnes, “Three-dimensional formation flying using bifurcating potential fields,” in Proceedings of the AIAA Guidance, Navigation, and Control Conference, Chicago, Ill, USA, August 2009.
[6] R. Sattigeri, A. J. Calise, and J. H. Evers, “An adaptive vision-based approach to decentralized formation control,” in Proceedings of the AIAA Guidance, Navigation, and Control Conference, pp. 25752798, Rhode Island, RI, USA, August 2004.
[7] D. Galzi and Y. Shtessel, “UAV formations control using high order sliding modes,” in Proceedings of the American Control Conference, pp. 4249-4254, Minneapolis, Minn, USA, June 2006.
[8] W. Ren and Y. Chen, “Leaderless formation control for multiple autonomous vehicles,” in Proceedings of the AIAA Guidance, Navigation, and Control Conference and Exhibit Keystone, vol. 1, pp. 505-514, Colorado, Colo, USA, 2006.
[9] A. Richards and J. How, “A decentralized algorithm for robust constrained model predictive control,” in Proceedings of the American Control Conference, pp. 4261-4266, Boston, Mass, USA, July 2004.
[10] D. Q. Mayne, J. B. Rawlings, C. V. Rao, and P. O. M. Scokaert, “Constrained model predictive control: stability and optimality,” Automatica, vol. 36, no. 6, pp. 789-814, 2000.
[11] A. Richards and J. P. How, “Model predictive control of vehicle maneuvers with guaranteed completion time and robust feasibility,” in Proceedings of the American Control Conference, pp. 40344040, Denver, Colo, USA, June 2003.
[12] T. Keviczky, F. Borrelli, and G. J. Balas, “A study on decentralized receding horizon control for decoupled systems,” in Proceedings of the American Control Conference, vol. 6, pp. 4921-4926, Boston, Mass, USA, 2004.
[13] K. D. Do and J. Pan, “Nonlinear formation control of unicycle-type mobile robots,” Robotics and Autonomous Systems, vol. 55, no. 3, pp. 191-204, 2007.
[14] W. Ren and R. W. Beard, “A decentralized scheme for spacecraft formation flying via the virtual structure approach,” in Proceedings of the American Control Conference, pp. 1746-1751, June 2003.
[15] J. R. T. Lawton, R. W. Beard, and B. J. Young, “A decentralized approach to formation maneuvers,” IEEE Transactions on Robotics and Automation, vol. 19, no. 6, pp. 933-941, 2003.
[16] J. Ghommam, H. Mehrjerdi, M. Saad, and F. Mnif, “Formation path following control of unicycle-type mobile robots,” Robotics and Autonomous Systems, vol. 58, no. 5, pp. 727-736, 2010.
[17] M. Chiaramonti, F. Giulietti, and G. Mengali, “Formation control laws for autonomous flight vehicles,” in Proceedings of the 14th Conference on Control and Automation Mediterranean, June 2006.
[18] W. B. Dunbar and R. M. Murray, “Model predictive control of coordinated multi-vehicle formations,” in Proceedings of the 41st IEEE Conference on Decision and Control, p. 4636, Las Vegas, Nev, USA, December 2002. [19] H. Lim, Y. Kang, J. Kim, and C. Kim, “Formation control of leader following unmanned ground vehicles using nonlinear model predictive control,” in Proceedings of the IEEE/ASME International Conference on Advanced Intelligent Mechatronics, pp. 945-950, Singapore, 2009. [20] K. Wesselowski and R. Fierro, “A dual-mode model predictive controller for robot formations,” in Proceedings of the 42nd IEEE Conference on Decision and Control, pp. 3615-3620, Maui, Hawaii, USA, December 2003.
[21] D. Gu and E. Yang, “A suboptimal model predictive formation control,” in Proceedings of the IEEE/RSJ International Conference on Intelligent Robots and Systems, pp. 3646-3651, 2005.
[22] X. Y. Zhang, H. Duan, and Y. X. Yu, “Receding horizon control for multi-UAVs close formation control based on differential evolution,” Science in China, vol. 53, no. 2, pp. 223-235, 2010.
[23] J. Shin and H. J. Kim, “Nonlinear model predictive formation flight,” IEEE Transactions on Systems, Man, and Cybernetics Part A: Systems and Humans, vol. 39, no. 5, pp. 1116-1125, 2009.
[24] Z. Weihua, T. H. Go, and E. Low, “Formation flight control using model predictive approach,” in Proceedings of the 47th AIAA Aerospace Sciences Meeting including the New Horizons Forum and Aerospace Exposition, Orlando, Fla, USA, January 2009.
[25] Z. Weihua and T. H. Go, “3-D formulation of formation flight based on model predictive control with collision avoidance scheme,” in Proceedings of the 48th AIAA Aerospace Sciences Meeting Including the New Horizons Forum and Aerospace Exposition, Orlando, Fla, USA, January 2010.
[26] J. Z. Sasiadek and D. S. Necsulescu, “Nonlinear control for UAV formation flying,” in Proceedings of the 17th World Congress The International Federation of Automatic Control, vol. 17, no. 1, part 1, Seoul, Korea, 2008.
[27] A. Richards and J. How, “Decentralized model predictive control of cooperating UAVs,” in Proceedings of the 43rd IEEE Conference on Decision and Control, vol. 4, pp. 4286-4291, Atlantis, Bahamas, 2004.
[28] F. Borrelli, T. Keviczky, and G. J. Balas, “Collision-free UAV formation flight using decentralized optimization and invariant sets,” in Proceedings of the 43rd IEEE Conference on Decision and Control, vol. 1, pp. 1099-1104, Atlantis, Bahamas, 2004.
[29] R. Fletcher and S. Leyffer, “Nonlinear programming without a penalty function,” Mathematical Programming B, vol. 91, no. 2, pp. 239-269, 2002.
[30] W. Ren and E. Atkins, “Nonlinear trajectory tracking for fixed wing UAVs via backstepping and parameter adaptation,” in Proceedings of the AIAA Guidance, Navigation, and Control Conference and Exhibit, pp. 3606-3616, August 2005.
[31] W. Ren, “On constrained nonlinear tracking control of a small fixed-wing UAV,” Journal of Intelligent and Robotic Systems, vol. 48, no. 4, pp. 525-537, 2007.
[32] “USER’S GUIDE FOR TOMLAB 7,” 2010, http://tomopt.com/.